
AIエージェントがWebサイトを閲覧しようとして「アクセスを拒否されました」と表示されることがあります。これはAIが嫌われているから、と片付けられる問題ではありません。検索流入の維持、無断転載への懸念、サーバー負荷、認証・セキュリティなど、サイト運営者にはいくつもの判断材料があります。
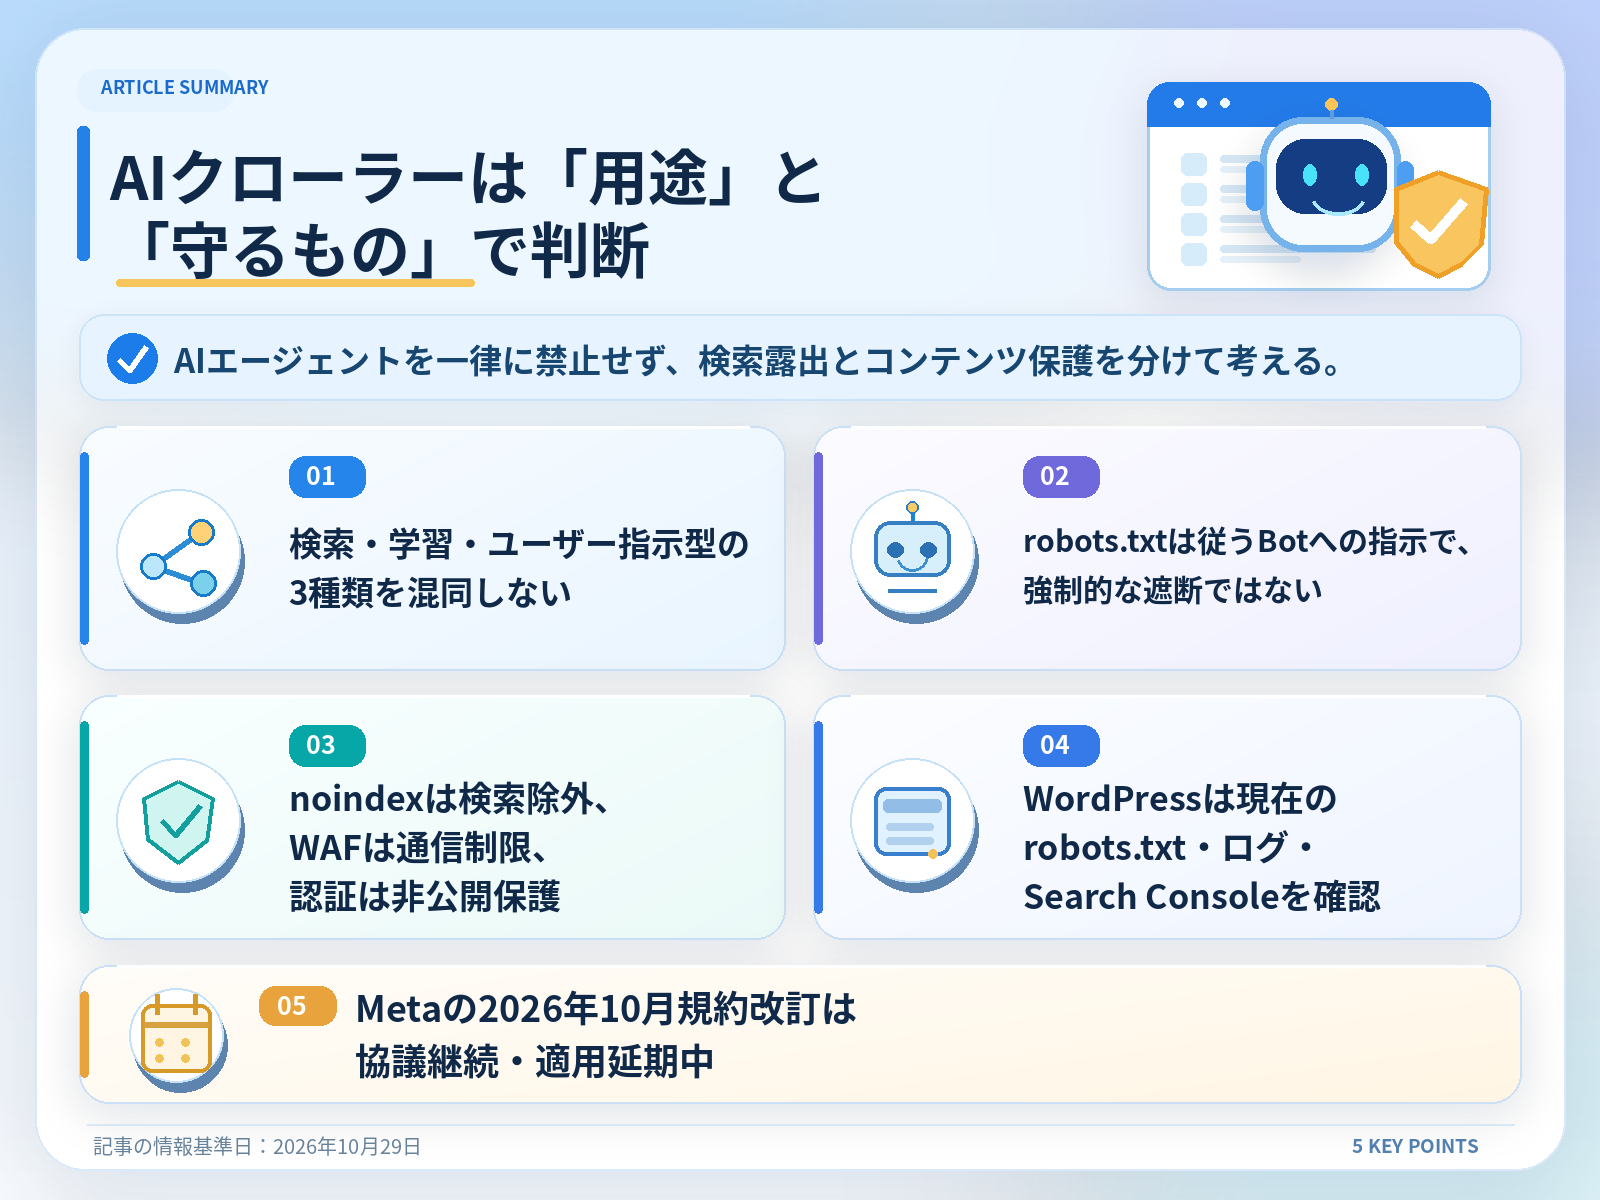
結論は「AIを一律に許可・禁止する」よりも、アクセスの目的ごとに判断すること。一般の検索クローラー、学習データ収集用Bot、利用者の依頼でページを取得するエージェントでは役割が違います。WordPressなら、まずrobots.txtと実際のアクセスログを確認し、必要に応じてWAFなどの防御を足す方法が現実的です。
この記事の情報基準日:2026年10月29日。 Metaの新しい商用規約は適用が延期され、10月28日には正式協議が終わるまで現行規約を維持する方針が報じられています。以下の規約経緯と技術的なBot対策は、別の論点として整理します。
なぜAIエージェントはWebサイトから拒否されるのか
サイト所有者が警戒する理由は、大きく「事業・権利」と「運用・安全」に分けられます。公開ページであることと、収集した内容をあらゆる用途に利用できることは同じではありません。
- コンテンツの価値:取材記事・比較表・独自データを大量収集されると、公開者が得る閲覧・広告・ライセンスの利益との釣り合いが問題になります。
- サーバー負荷:短時間に大量のページやクエリを要求されると、共有サーバーや管理画面の応答が悪くなる可能性があります。
- 品質と安全性:古い情報を再利用されたり、ログインや登録を必要とする領域を狙われたりすると、コンテンツ管理やアクセス権限の問題が生じます。
- 目的の違い:検索結果にリンクを表示する収集と、AIの学習や回答生成に使う収集では、運営者の許容範囲が一致しないことがあります。
一方で、すべての自動アクセスが有害というわけでもありません。検索やリンクプレビューが機能することで新規読者に届く面もあり、ユーザーが明示的に依頼したAIの閲覧まで一律に止めるかは別の検討が必要です。
Metaの商用規約問題は何が争点になった?
2026年10月、MetaがFacebookやInstagramなどのビジネス利用者向けに示した新しい商用規約で、ビジネスに「関連する」Webページを自動収集できると読める文言が問題視されました。報道では、対象範囲の広さと、商用アカウントを利用するだけで収集の許諾につながり得る点が論点になっています。
| 日付 | 確認された動き | 何を意味する? |
|---|---|---|
| 10月15日 | Nieman Labが規約案と専門家の懸念を報道 | 事業者が関連サイトの取得を許可する条項の解釈が議論に |
| 10月16〜17日 | Metaが「train」の文言を削除し、用途を広告・ビジネス製品に限定する方向で修正 | 明示的なAI学習という表現は削除。ただし収集範囲への懸念は残る |
| 10月23〜26日 | 適用予定を10月30日から11月20日に延期 | 予定日が変わっただけで、懸念がすべて解消したわけではない |
| 10月28日 | 出版・業界団体と全面的に協議するまで変更を進めない方針を表明 | 11月20日を超える延期もあり得る。現行規約を維持する方針 |
Meta側は「AIサービス向けに無制限に使える権利を得る」という解釈を否定し、robots.txtによるサイト管理者の希望を尊重すると説明しています。一方、出版社側や法律専門家は、条項の書き方が広すぎること、robots.txtへの配慮が規約本文に十分明示されていないことなどを引き続き懸念しています。どちらの解釈が法的に正しいか、現段階で確定したものではありません。
この規約は「提案された新しい商用規約」の話です。2026年10月29日時点で、それが10月30日から実際に施行されたかのように書くのは誤りです。確認には Nieman Labの10月26日の続報、10月28日の続報、Reutersの10月28日報道を参照しています。
今回の教訓は、技術的に取得できるか・規約で許諾されているか・著作権など別の権利を侵害しないかは分けて考えることです。robots.txtはWeb上のアクセス希望を伝える手段ですが、契約や権利に関する争いを一つの設定だけで解決するものではありません。
検索クローラー・AI学習Bot・操作エージェントは何が違う?
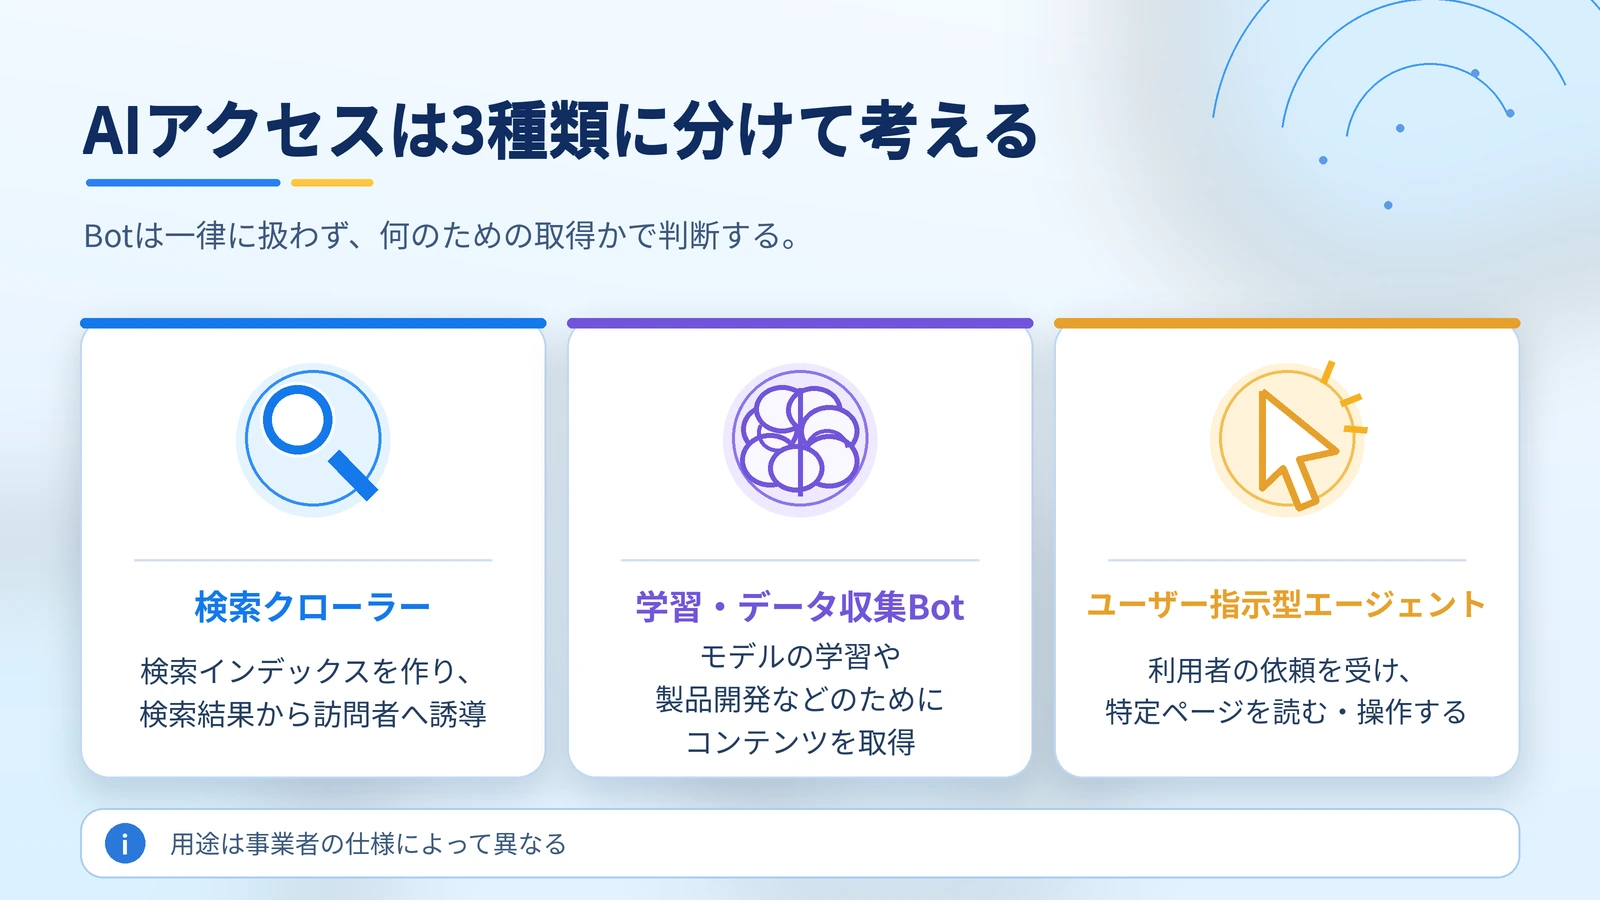
「AIのアクセス」とひとまとめにする前に、少なくとも次の3つへ分解すると判断しやすくなります。
| 種類 | 主な目的 | サイト側が判断するポイント |
|---|---|---|
| 検索クローラー | 検索インデックスを作り、検索結果から訪問者へ誘導 | 検索露出を残したいか、クロール負荷は適正か |
| 学習・データ収集Bot | モデルの学習や製品開発などのためにコンテンツを取得 | 利用範囲・提供価値・ライセンス方針 |
| ユーザー指示型エージェント | 利用者の依頼を受け、特定ページを読む・操作する | 利用者の利便性と認証・濫用リスク |
厳密にはサービスごとに用途の区分が異なり、1つの事業者が複数種類のBotを運用することもあります。HTTPのUser-Agent名だけで相手を確実に識別できるわけでもありません。文字列は偽装できるため、必要な場面では事業者が案内するIP情報、DNS検証、WAFのBot分類なども確認します。
GooglebotとGoogle-Extendedは同じではない
Googleの公式資料では、一般のGooglebotへのクロール設定と、Google-Extendedというプロダクト利用の制御は別に説明されています。Google-Extendedを使った指定は、Gemini関連の学習や一部グラウンディングへの利用を制御するためのものです。Google-Extendedの設定自体はGoogle検索への掲載や検索順位のシグナルに影響しないと明記されています。
ただし、Google-Extendedは独立したHTTPのUser-Agentではありません。サーバーログで「Google-Extendedという名前のアクセス」を探せば見つかる、というものではない点にも注意が必要です。出典:Googleの一般的なクローラー一覧。
robots.txt・noindex・WAF・ログイン制限はどう違う?
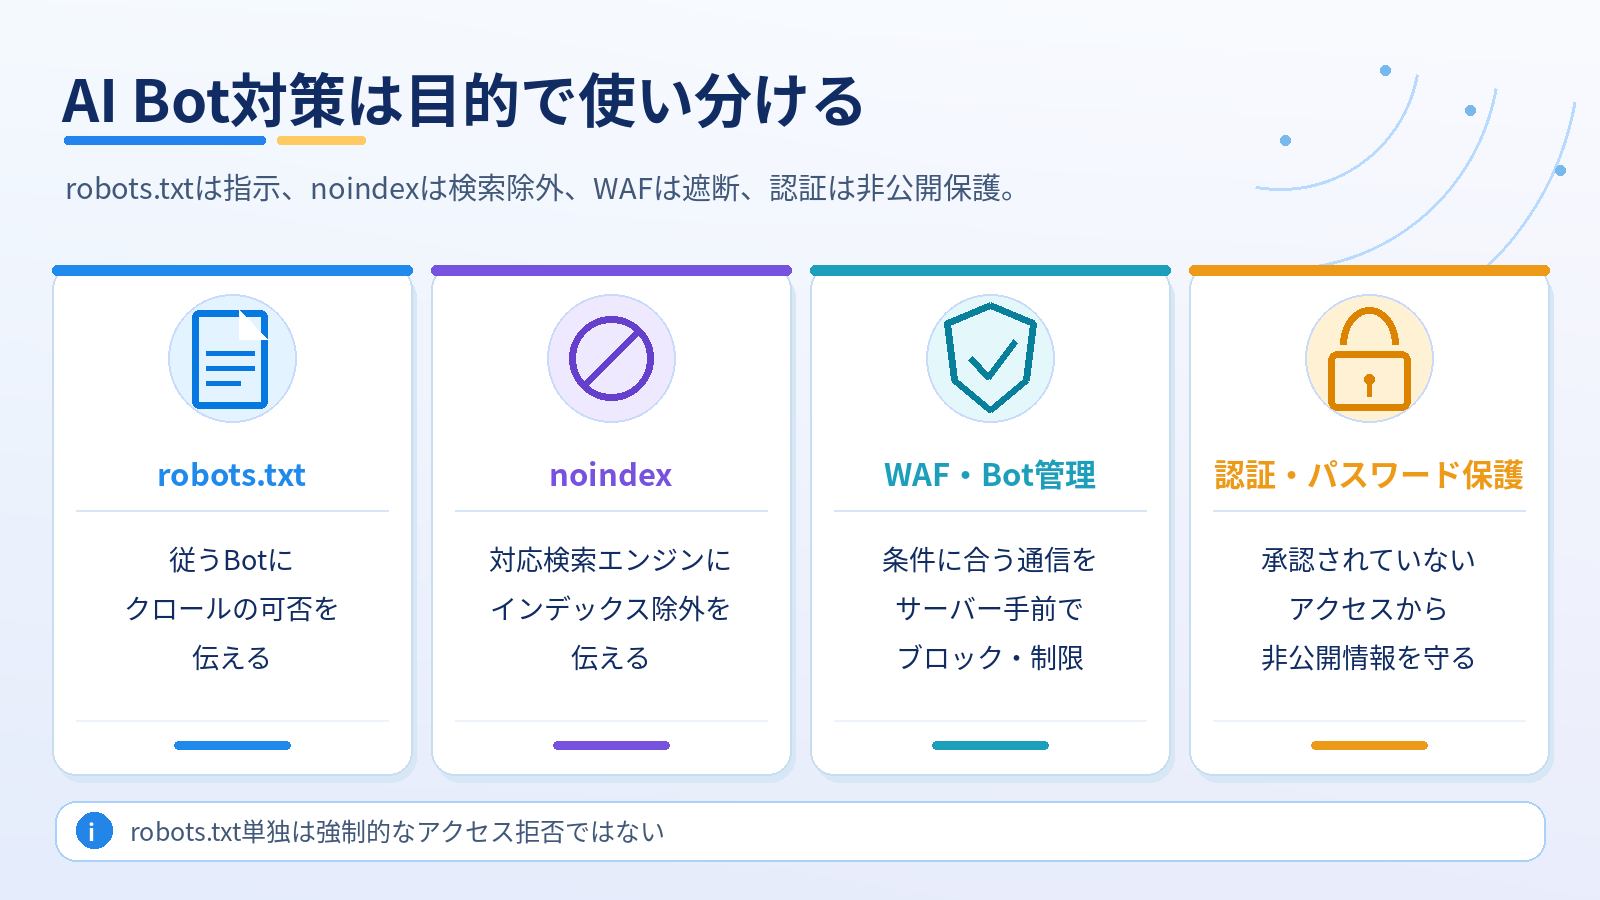
ここが、WordPress運営者が最も間違えやすい部分です。似た機能に見えても、止める対象が異なります。
| 手段 | 制御すること | できないこと・注意 |
|---|---|---|
| robots.txt | 従うBotにクロールの可否を伝える | 強制的なアクセス拒否や検索結果からの完全削除を保証しない |
| noindex | 対応検索エンジンにインデックス除外を伝える | 閲覧そのものを止めない。Botがページを読める必要がある |
| WAF・Bot管理 | 条件に合う通信をサーバー手前でブロック・制限 | 誤判定で正規クローラーや利用者を止めるリスク |
| 認証・パスワード保護 | 承認されていないアクセスから非公開情報を守る | 公開記事の検索流入を残す用途とは通常両立しにくい |
Google公式は、robots.txtはページを検索結果から隠すための仕組みではないと説明しています。また、noindexをGoogleに認識させるには、そのページがrobots.txtなどでクロール禁止になっていないことが必要です。robots.txtとnoindexを同時に設定しただけで安心しないようにしましょう。
ログイン限定情報や公開していない下書き・会員データを守る目的なら、robots.txtではなくアクセス認証とサーバー側の権限制御が必要です。robots.txtのGoogle公式解説、noindexの公式解説も参照してください。
WordPressでAIクローラーへの対応を始める手順
1. 現在のrobots.txtを確認する
自サイトの https://自分のドメイン/robots.txt をブラウザで開き、すでに書かれているルールを確認します。WordPressは仮想的なrobots.txtを出力する場合があり、テーマやSEOプラグイン、サーバー上の実ファイル、CDN設定などで実際の出力が変わることがあります。
まず既存ルールを保存し、User-agent: * の下に重要なクロール許可があるか、SitemapやGooglebotの扱いに問題がないか確認しましょう。WordPressの標準出力は do_robots() に実装され、robots_txtフィルターで加工できます。
2. 目的別のルールを検討する
例えばGoogle検索への露出を残しつつ、Google-Extendedで扱われる利用についてサイトの意思を示したい場合は、次のような指定を検討できます。これは全AIアクセスを遮断するコードではありません。Googleが公開する個別のプロダクトトークンに対する例です。
User-agent: Google-Extended
Disallow: /
この設定を実施する場合は、サイト全体のrobots.txtに追加する位置や既存グループとの関係を確かめてください。WordPress・Cocoon・SEOプラグインの自動生成を使っている場合、サーバー上に別のrobots.txtを置くと意図しない競合が起きる可能性があります。
Googlebot全体をDisallow: /にするのは別の操作で、検索露出へ大きな影響を与えかねません。Google-Extendedのような用途別トークンは、その時点の事業者公式資料を見て判断します。
3. アクセスログとCloudflareの状態を見る
サーバーのアクセスログやCloudflareのAI Crawl Controlが利用できるなら、実際にどのクローラーが何回アクセスし、失敗・遮断・robots.txt違反が起きているかを確認します。アクセス元・リクエスト数・403/429/5xx応答・特定URLへの集中などを把握すると、一般論ではなく運用状況から対策を決められます。
CloudflareのAI Crawl Controlでは、対象BotごとのAllow/Block、違反状況の確認が案内されています。ただし提供プランや検出方式に差があり、User-Agent名だけによる判定には偽装の可能性も残ります。無料プランの分類性能まで同一と考えないようにします。出典:Cloudflare公式ドキュメント。
4. 設定変更後は検索・表示を再チェック
変更前のrobots.txt、変更した日時と理由を保存し、Google Search Consoleのインデックス状況、検索クリック数、サーバー負荷を確認します。設定直後の短い期間で因果を断定することは難しいため、少なくとも変更内容と観測期間を残しておきます。
AIクローラーは一律禁止すべき?サイト別の判断表
無条件の全Bot拒否はシンプルですが、記事が見つかりにくくなったり、AI経由の参照機会を減らしたりする可能性もあります。目的に応じてルールを分ける方が合理的です。
| サイトの目的 | 優先する確認 | 考え方 |
|---|---|---|
| 一般公開の記事ブログ | Googlebotの検索露出・参照元アクセス | 検索クロールは維持し、学習用途の方針は別途検討 |
| 独自データ・調査記事が中心 | 再利用条件、契約、ログ、Botごとの用途 | 無差別遮断より目的別ルールと利用条件の明確化を検討 |
| 会員限定・社内情報 | 認証・権限・非公開設定 | robots.txtの設定よりサーバーでのアクセス制限を優先 |
| アクセス集中で負荷が高い | 急増したIP・URL・User-Agent・応答コード | WAF・レート制限など具体的なアクセス対策を検討 |
有料のコンテンツ提供やライセンス交渉についても、技術上のブロックとは別の話です。例えばCloudflareが案内するPay per Crawlは非公開ベータを含む仕組みで、すべてのサイトがすぐ利用できる標準機能ではありません。
AIエージェントがWordPressの管理画面を操作する問題は、外部からコンテンツを読むBotとは逆の立場です。管理側の最小権限については、既存記事「AIエージェントにWordPress管理者権限を渡して大丈夫?」で扱っています。エージェントの強制制限・安全装置については「AIエージェントはなぜプロンプトだけでは安全にできない?」へつなげられます。
個人サイトが決めておきたい「AIアクセス方針」
おすすめは次の順番です。観測 → 目的別分類 → 対策 → 影響確認という運用を定期的に繰り返します。
- 観測:robots.txtとアクセス状況を確認。異常なクロールを見つけたらリクエスト先も調べる。
- 目的別分類:検索・学習・ユーザー指示型アクセスを混同しない。事業者の公開資料も見る。
- 対策:まず意図をrobots.txtで示し、守られないアクセスにはWAFや認証を検討する。
- 影響確認:Google Search Consoleやサーバーログで、誤遮断と検索流入変化を確認する。
- 更新:Metaなどの規約、Google・AI事業者のBot仕様変更に応じて見直す。
今回のMetaの一連の動きは、「AIが取得する技術」と「Webのコンテンツをどう利用してよいか」というルールの整備が追いついていないことを示しています。WordPress運営者として必要なのは、すべてのAIを敵視することでも、公開情報を無条件に差し出すことでもありません。検索流入を損なわず、守るべき情報や権利を適切に守れる設定を選ぶことです。
AIクローラー対策でよくある疑問
robots.txtで拒否すればアクセスを完全に止められますか?
いいえ。robots.txtは準拠するクローラーに対する指示であり、認証・ファイアウォールのような強制的な防御ではありません。非公開情報はアクセス制御で守ります。
Google-ExtendedをブロックするとGoogle検索に表示されなくなりますか?
Google公式は、Google-Extendedの制御はGoogle検索へのサイト登録や検索ランキングのシグナルに影響しないと説明しています。ただしGooglebotそのもののクロールを止める操作とは混同しないでください。
Metaの商用規約は2026年10月30日に施行されますか?
いいえ。10月23日に11月20日へ延期され、10月28日には出版社などとの協議が終わるまで変更しない方針が発表されました。11月20日も確定した適用日とは言えません。以後の変更は公式規約と信頼できる続報で確認してください。
AIが自分の記事を読んだことを確実に調べられますか?
アクセスログは重要な手掛かりですが、ユーザーエージェントは偽装でき、CDNやキャッシュ経由で本文を取得される場合もあります。ログに現れないから未利用、現れたから学習利用された、と断定することはできません。
参考にした公式資料・主要報道
- Reuters(2026年10月28日):Metaの商用規約に関する協議と延期の方針
- Nieman Lab(2026年10月17日):規約修正文言と法律家の懸念
- Nieman Lab(2026年10月28日):出版社との協議および法的動向
- Google:robots.txtの概要
- Google:noindexによる検索結果からの除外
- Google:一般的なクローラーとGoogle-Extended
- WordPress Developer:robots_txtフィルター
- Cloudflare:AI Crawl Controlの公式ドキュメント
※本記事は公開情報を基にした一般的な技術解説であり、個別サイトの法的適法性を判断する法律相談ではありません。最新の利用規約と各Bot仕様は変更される可能性があります。
コメント