
DeepSeekが2026年10月17日に公開したSearch APIとFetch APIは、生成AIによる記事制作の「調べる工程」を外部APIとして組み込める新しい選択肢です。どちらも成功リクエスト1,000回あたり0.75ドルですが、検索結果が返ったことと、記事の内容が正確なことは別問題です。
先に結論を言えば、候補URLの収集と原文テキストの取得には有用。ただし信頼性の判断や一次資料の照合は別工程として残す、という導入が現実的です。この記事では公式仕様を基に、Pythonでの基本的な呼び出し方、Codex/Claude Codeとの関係、WordPressの記事制作フローへの接続を整理します。
※2026年10月19日時点の公開資料による調査です。筆者によるDeepSeek APIのキーを用いた日本語検索・速度・網羅性の実測比較は行っていません。仕様・料金は今後変更される可能性があります。
DeepSeek Search APIは記事制作の何を変えるのか
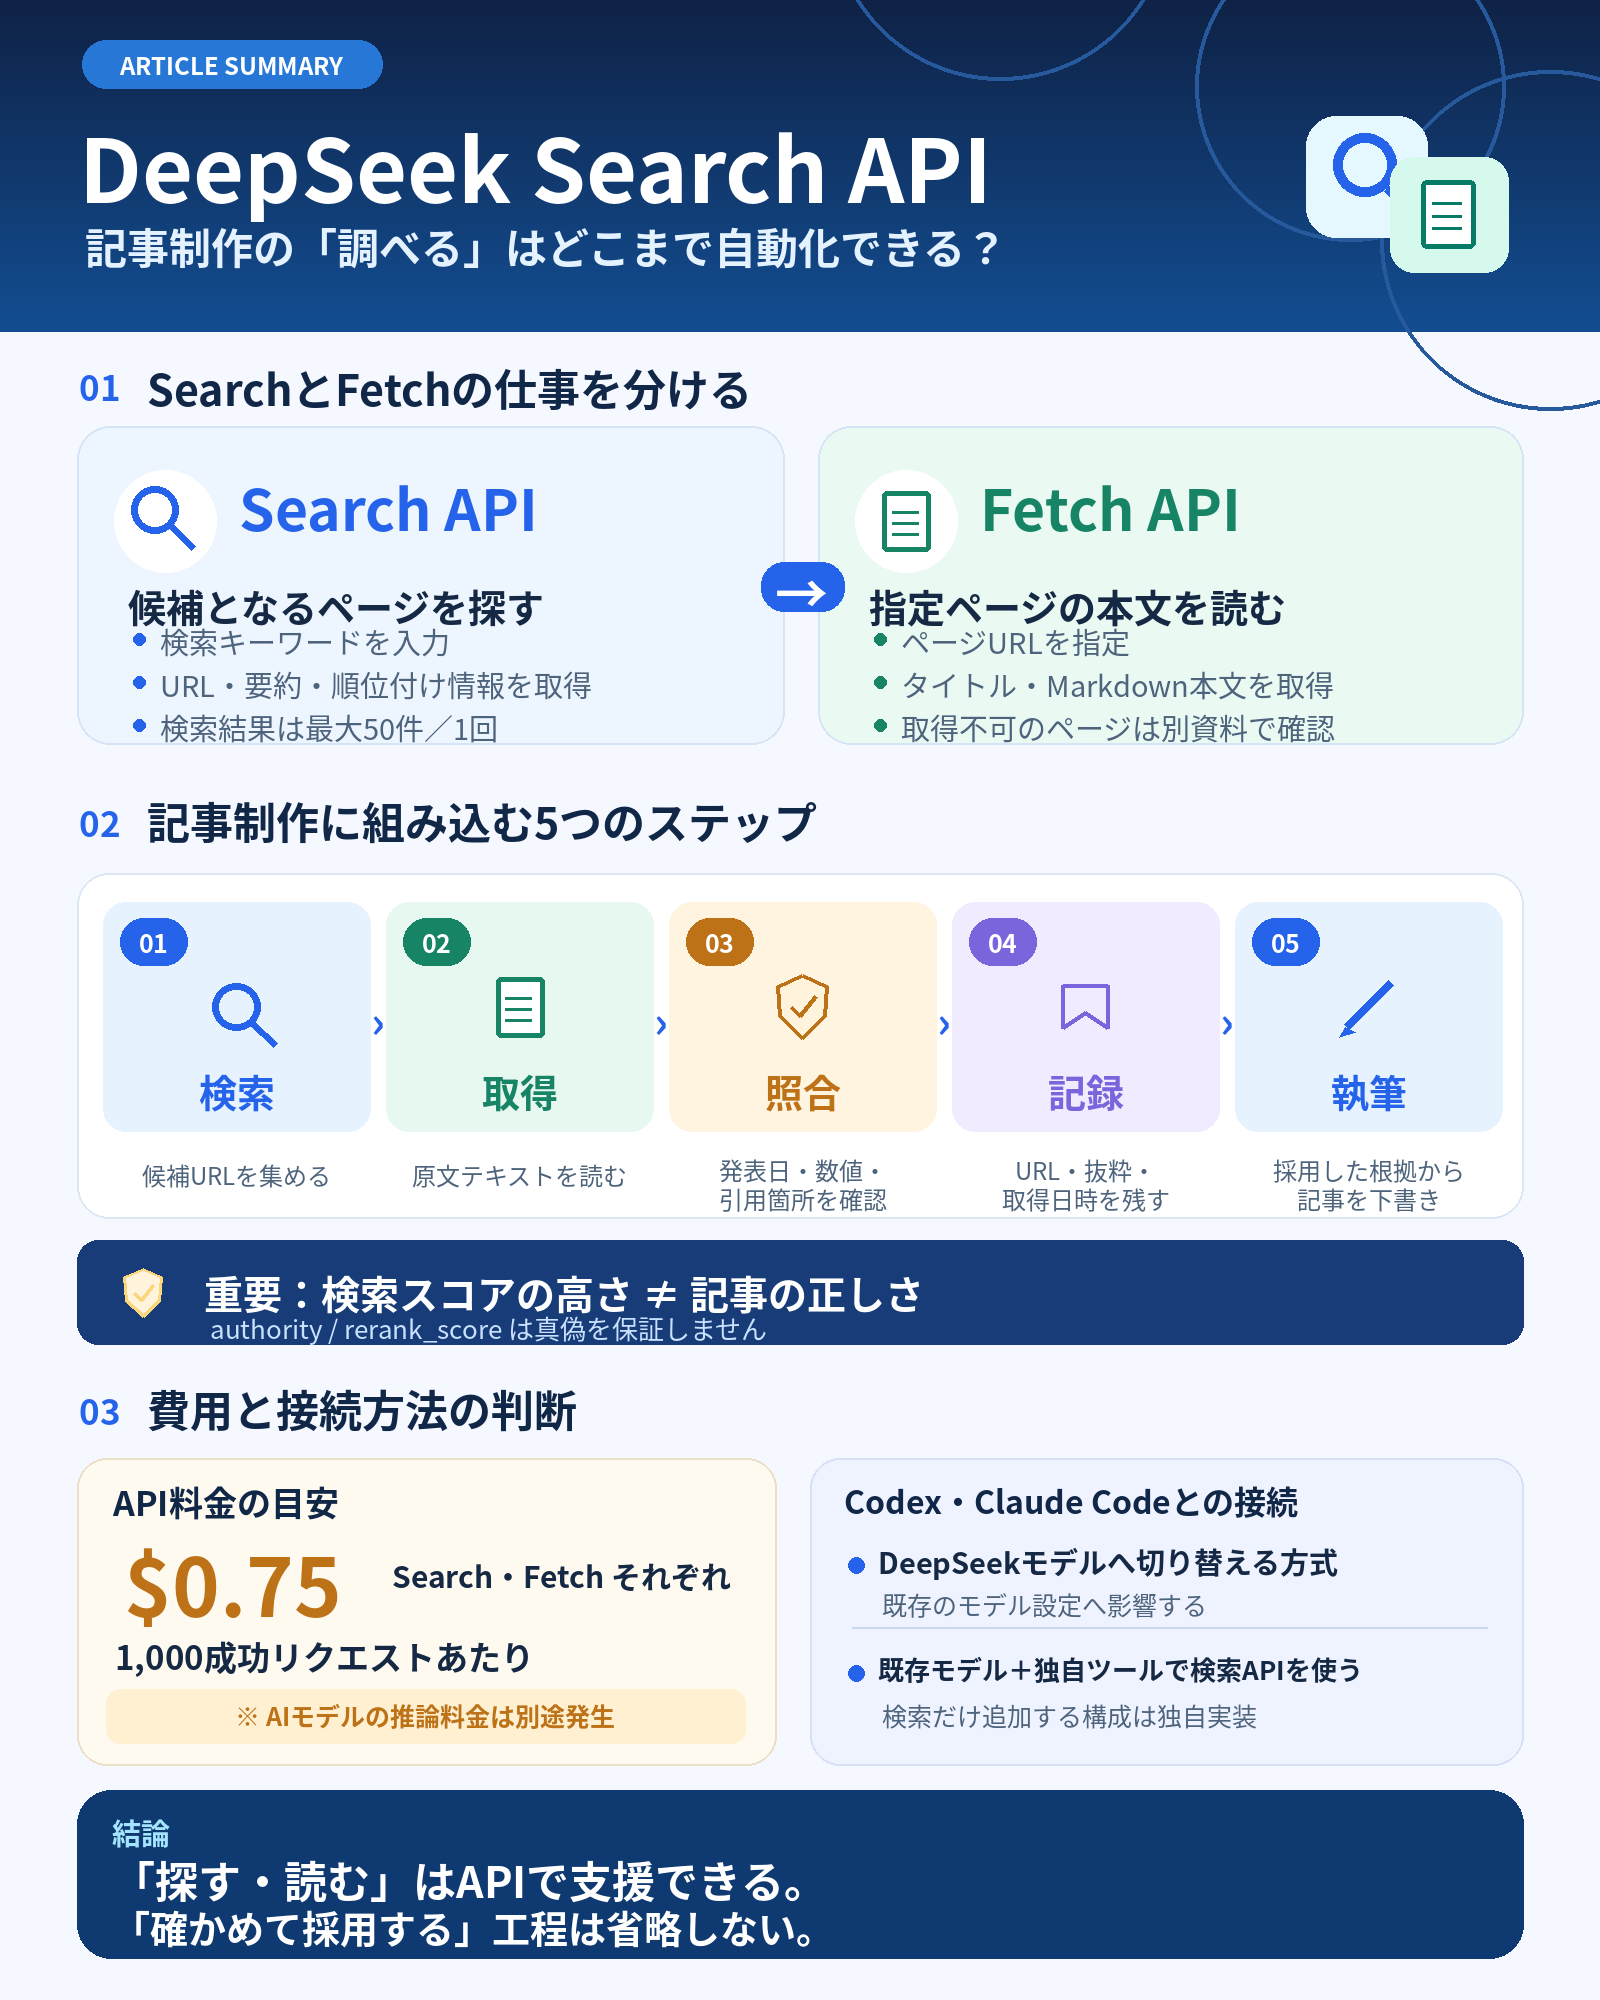
DeepSeekは2026年10月17日の更新情報で、自社検索エンジンを利用したSearchとFetchの公開を発表しました。SearchはWebの関連ページを探し、Fetchは指定されたページをMarkdown(見出しや段落を簡潔な記法で表したテキスト)へ変換します。モデルに全文を丸投げする前に、検索と取得をプログラムで分けて管理できる点が実務上の変化です。出典:DeepSeek公式発表。
例えば、WordPressプラグインの新機能を解説するときには「公式発表ページを見つける」→「公開日と仕様の本文を読む」→「旧版ドキュメントとの違いを確かめる」と段階を分けられます。検索エンジンやRAG(検索した文書をAIの回答材料にする仕組み)の開発者だけでなく、記事制作を自動化する個人サイト運営者にも関係があります。
ただし「DeepSeekの検索エンジンが必ず優れている」「Google検索や既存のChatGPT検索を置き換えられる」といった結論は、同じ条件での実測比較なしには出せません。
Search APIとFetch APIの違い:検索と原文取得を分ける
| 比較する点 | Search API | Fetch API |
|---|---|---|
| 目的 | キーワードから候補ページを探す | 指定URLの本文を取得する |
| 入力 | query、count、need_contentなど | url |
| 主な返却値 | title、url、snippet、summary、date、評価スコアなど | titleとMarkdown形式のcontent |
| 記事制作での役割 | 調査対象のURL候補を選ぶ | 根拠文があるか確認する |
| 代表的な失敗 | 一致する結果がゼロ件 | 403などで取得拒否、404で本文取得不可 |
Searchではqueryが1〜128文字、countが1〜50件に制限されています。標準は10件。site:で検索するサイトを絞ったり、after:で公開日の条件を付けたりできます。need_content: trueを使うと検索結果に本文テキストが入る場合もありますが、対象ページによって空欄になるため、必要に応じてFetchを使い分けます。出典:Search & Fetch公式ガイド。
Searchのレスポンスにはrerank_score(関連性・時期などの順位付けスコア)とauthority(サイト側の権威性を表す独自指標)が含まれます。仕様上、rerank_scoreは0〜3、authorityは-1〜4の範囲です。これらは検索結果を並べ替える目安であり、論文の質、法的な正しさ、公開日や数字の正確さを保証するものではありません。
検索結果のdateがnullになる場合もあります。また、ページが更新されても記事中で引用した統計値の調査年まで同時に新しくなるわけではありません。日付を自動的に信じない設計が必要です。
Fetchは対象サイトのアクセス制限やページ形式の影響を受けます。取得できないURLを無理に突破する前提ではなく、公開された公式ドキュメントや代替資料を探し直す方法を用意します。
料金はいくら?100記事を調べた場合の計算
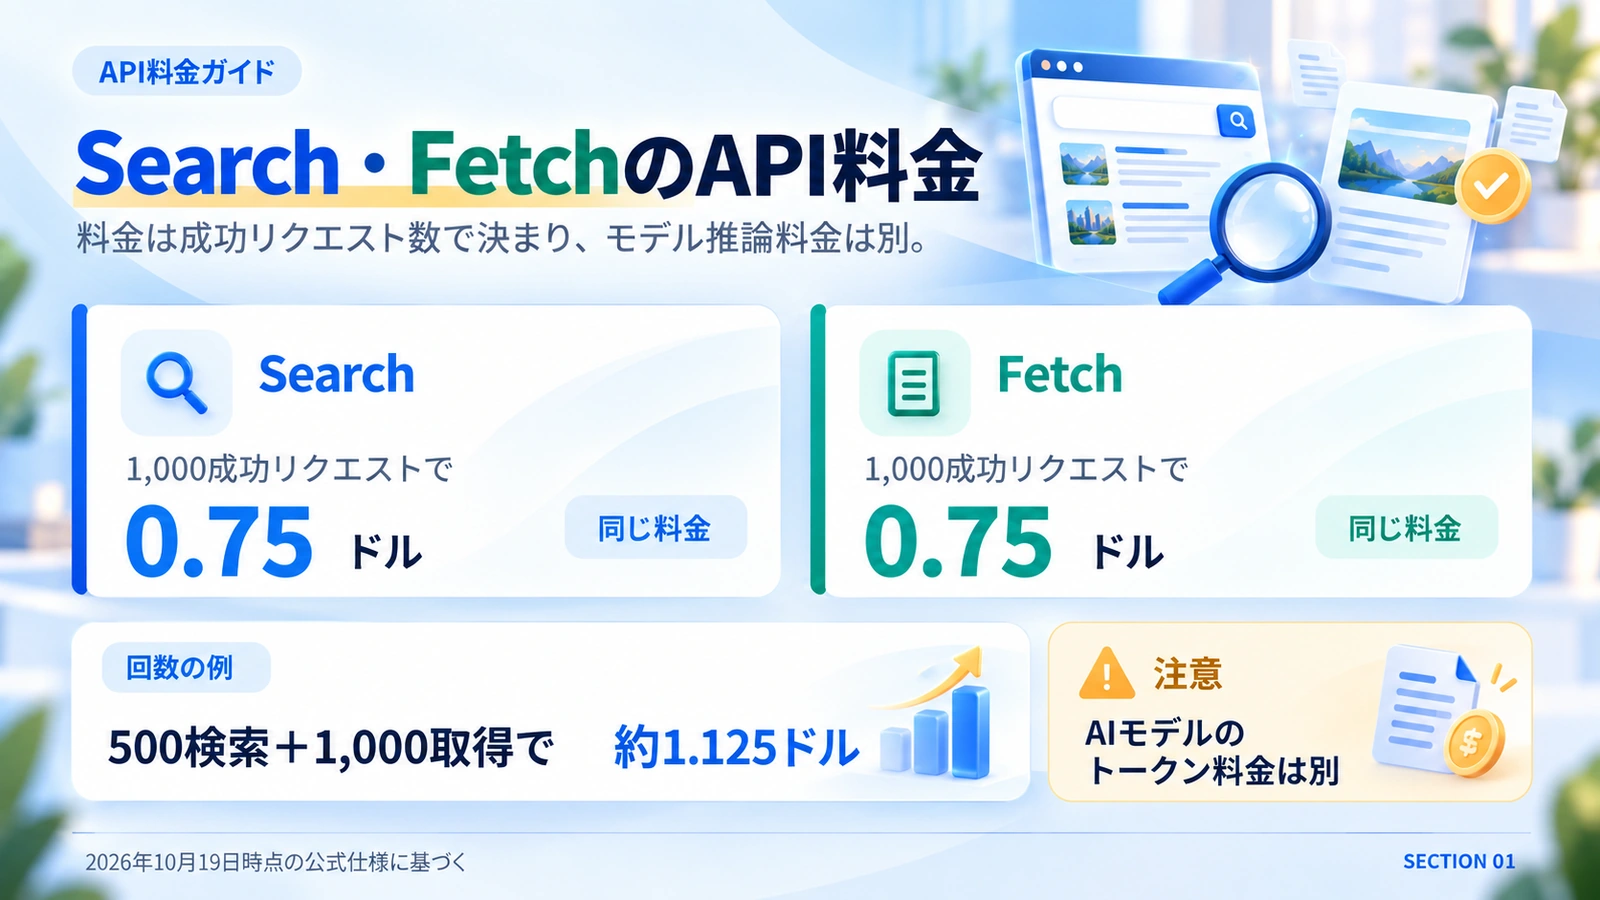
SearchとFetchはそれぞれ1,000成功リクエストあたり0.75ドルです。検索結果を10件返しても50件返しても、同じ1回の検索リクエストとして数えられます。SearchはHTTP 200で結果が1件以上ある場合、FetchはHTTP 200で本文が得られた場合に課金対象となり、空の検索結果・失敗・タイムアウトは対象外です。
| 利用例 | Search | Fetch | API料金の概算 |
|---|---|---|---|
| 1記事につき検索5回+本文10ページ | 5回 | 10回 | 約0.01125ドル/記事 |
| 100記事を同じ条件で作る | 500回 | 1,000回 | 約1.125ドル |
| 1,000検索+1,000ページ取得 | 1,000回 | 1,000回 | 1.50ドル |
上の金額は全リクエストが課金対象となる成功ケースを想定した、Search・Fetchだけの試算です。実際の工程ではモデルの入力・出力トークン代、再調査、保存や実行環境の費用が別途生じます。為替による日本円での支払額も変わります。
APIごとのアカウント上限はSearchが毎秒5リクエスト、Fetchも毎秒5リクエストです。Fetchには対象ドメイン単位の制限もあります。大量に同じサイトへ送らないよう制限を設け、429(送信過多)なら間隔を空けて再試行する設計が必要です。
無料期間の扱いに注意:DeepSeekの料金ページでは、DeepSeek HarnessやClaude Code、CodexでDeepSeek APIを使った際のサーバー側検索・取得ツールの従量課金開始が北京時間2026年11月1日0時(日本時間同日1時)と明記されています。これは「Search/FetchのAPIを自分で直接呼べばすべて無料」という意味ではありません。出典:DeepSeek公式料金ページ。
PythonからSearch・Fetchを使う最小構成
独自の情報収集工程に組み込む場合、DeepSeekモデルへ切り替えなくても、Search APIをHTTPリクエストとして利用する構成を設計できます。以下は公式エンドポイントとリクエスト形式に基づく基本例です。実際のAPIキーによる動作検証はしていません。
APIキーはソースコードへ直接書かず、事前にターミナルや秘密情報管理機能でDEEPSEEK_API_KEYを設定してください。pip install requestsで依存ライブラリを用意します。
import os
import requests

BASE = "https://api.deepseek.com/v1/tools"
KEY = os.environ["DEEPSEEK_API_KEY"]
HEADERS = {"Authorization": f"Bearer {KEY}"}


def call_api(endpoint, payload):
    res = requests.post(
        f"{BASE}/{endpoint}",
        headers=HEADERS,
        json=payload,
        timeout=20,
    )
    res.raise_for_status()
    return res.json()

results = call_api("search", {
    "query": "WordPress Abilities API site:developer.wordpress.org",
    "count": 5,
    "need_content": False,
})["results"]

for item in results:
    print(item["title"], item["url"])

# 取得可否と利用条件を確認したURLに限定してFetchを使う
if results:
    page = call_api("fetch", {"url": results[0]["url"]})
print(page["title"], page["content"][:400])この例はAPIの動きを理解する最小形です。実運用ではURLの検査、リトライの回数制限、429への待機、429以外の4xxエラーの切り分け、取得結果の保存、ドメインへの配慮を追加します。特に、外部から渡されたURLをそのまま内部ネットワークへのアクセスに使わないよう、接続先を制限してください。
記事用の根拠収集では、単に取得したMarkdownを文章生成モデルへ渡すのではなく、取得日時・URL・使った検索語・確認した原文の該当箇所を記録すると後から再検証できます。
Codex・Claude Codeとの連携は「モデル変更」と「検索だけ追加」を分ける
DeepSeek公式にはCodexとClaude Codeの統合ガイドがありますが、標準で紹介されるのは主にAIのバックエンドをDeepSeekモデルへ切り替える設定です。現在のOpenAIモデルやAnthropicモデルをそのまま使い、検索だけDeepSeekに変更する手順と同じではありません。
Claude CodeではWeb SearchをDeepSeek API経由で利用できる
Claude CodeはDeepSeekのAnthropic互換APIを設定すると、DeepSeekモデルによるコード作業を利用できます。公式ガイドではClaude CodeのWeb Search機能がDeepSeek側で処理されることが説明され、検索費用のほか、結果を要約するモデルのトークン料金が発生します。既存プロジェクトを触る場合、環境変数でモデル接続先が変わることに注意してください。出典:DeepSeek公式Claude Codeガイド。
Codexでは設定変更の影響範囲を確認する
DeepSeek公式のCodex統合ガイドは、~/.codex/config.tomlなどを変更し、DeepSeekをモデルプロバイダーに追加する方法です。この構成例ではweb_searchをdisabledにしている点に注意が必要です。他方、DeepSeekのResponses API説明ではDeepSeek V4 Pro向けのサーバー側Web検索ツールが紹介されています。したがって、単に「CodexにDeepSeekを設定すれば標準Web検索も必ず使える」とは書けません。利用モデル・クライアント・設定によって変わります。出典:公式Codexガイド、Responses API仕様。
設定スクリプトが提供されていても、すでにMCPや複数モデルを設定している環境では変更前の設定ファイルを別途バックアップし、どの項目が置き換わるかを確認した方が安全です。APIキーを共有リポジトリへコミットしたり、ブログのスクリーンショットへ写し込んだりしないようにします。
モデルを替えず検索APIだけを使う構成
現在のCodexのモデルを維持するなら、Pythonスクリプトや自作MCPツールでDeepSeek Search/Fetchを呼び、得られた結果を既存のAIへ渡す方法が考えられます。これはDeepSeek公式が保証する「Codexの標準検索差し替え機能」ではなく、独自の統合設計です。実装・認証・監査・費用の責任が自分の側に残るため、運用規模が小さければ無理に導入しない選択もあります。
記事の信頼性を保つには検索結果をどう検証する?
検索順位やauthorityが高くても、それだけで事実を採用しない。記事制作では、出典の種類と更新日時、原文での数値・用語を照合して初めて採用できると考えます。
- 一次資料を優先:API仕様は公式ドキュメント、制度は公的機関、医療はガイドラインや原著論文を探す。
- 日付の意味を分ける:検索インデックス上の日付、発表日、記事更新日、統計の対象年を混同しない。
- 原文を引用点で確認:FetchされたMarkdown中に主張を裏づける箇所があるか調べる。画像の表、PDF内の図、JavaScriptで表示される内容は欠ける可能性がある。
- 反証を探す:重要な数値・料金・法制度は別の一次資料や版管理情報も確認する。
- 根拠を保存:URLだけでなく確認日時・記事で使用する主張・本文抜粋・照合結果を残す。
DeepSeekの検索要約や取得本文は、AIにとって「外部から届く未検証のデータ」です。ページに書かれた指示をAIの操作命令として実行しないこと、個人情報や認証情報を丸ごと検索エンジン・言語モデルへ渡さないことも重要です。
Searchで探す → Fetchで読む → 重要な主張を原文と照合する → 根拠を記録する → briefを作る、の順に分ける。
WordPress記事制作のどの工程へ組み込むのがよいか
記事を公開するまでをすべて一度に自動化するより、検索と検証の間に人またはプログラムによる採用判定を置く方が、後から誤りを訂正しやすくなります。
| 工程 | Search・Fetchの役割 | 最終判断 |
|---|---|---|
| 企画・検索意図 | Searchで公式ソース候補を集める | 調査対象が適切か編集者が確認 |
| 根拠収集 | Fetchで原文を取得し保存する | 出典・日付・文脈を照合 |
| 記事brief | 事実と未確定事項を仕分ける | 裏づけの弱い主張を除外 |
| 本文作成 | AIへ採用済み根拠を渡す | 断定と引用の対応を確認 |
| 投稿パッケージ | Gutenberg HTMLと画像計画を準備 | 公開前のレビューを残す |
例えばJSONにclaim(記事で述べたい内容)、source_url(根拠URL)、retrieved_at(取得日時)、evidence(根拠となる原文)、review_status(人が確認したか)を記録します。重要な主張ほど「source_urlがある」だけでなく、evidenceが主張に対応しているかの確認を残したいところです。
WordPress側への投稿権限の扱いは、別記事「AIエージェントにWordPress管理者権限を渡して大丈夫?」で詳しく整理しています。DeepSeek Search/Fetchは調査工程のサービスであり、WordPressへ記事を公開するための権限を自動的に与えるものではありません。
一方、検索先サイトにもアクセス方針があります。Fetchの403や404を「制限の回避が必要」と扱わず、情報提供側のルールを踏まえて運用することが重要です。AIエージェントが外部アクセスする際の安全設計については「AIエージェントはプロンプトだけでは安全にできない」も関連します。
DeepSeek Search APIを採用する人・見送る人
APIの単価が低いこと自体は魅力ですが、記事制作にかかる時間の大半が「根拠の検証」「執筆」「更新」なら、検索を置き換えただけで制作負荷が激減するわけではありません。
| 採用を検討しやすい条件 | 見送りを考えたい条件 |
|---|---|
| 定期的に多数の記事の候補URLを収集する | 月に数件だけ調べれば十分 |
| 公式ページを機械的に抽出し保存する仕組みがある | 検索後の検証ルールがない |
| Python・MCPなどの保守を自分で行える | 現在のCodexやClaude Codeの設定が複雑で変更リスクが高い |
| 出典管理を含むフロー全体を改善したい | APIが返す要約をそのまま本文にしたい |
まずは既存の検索経路を残し、同じ日本語クエリで公式資料の発見率・日付の正確さ・Fetch成功率・1記事当たりの成功リクエスト数を記録する小規模検証が適切です。少なくとも公開日や料金が頻繁に変わる技術記事で、何を取りこぼすかを見てから本格導入を判断しましょう。
今回の記事の結論は、DeepSeek Search/Fetchは記事制作の「探す・読む」を支える候補として有望だが、信頼性を保証する装置ではない、というものです。公式の検索スコアではなく、採用した根拠を自分で説明できるワークフローへ組み込むかどうかが判断の分かれ目です。
よくある質問
Searchだけで本文も確認できますか?
need_content: trueを指定すると検索結果に本文が含まれることがあります。ただし空欄の場合もあるため、出典の重要箇所はFetchでの取得や公式原本の目視確認を併用します。
Search APIは検索結果の件数ごとに課金されますか?
いいえ。公式の料金単位は結果件数ではなく、条件を満たした成功リクエスト数です。countを増やしただけでリクエスト単価は増えません。
CodexをDeepSeekモデルへ変更しないとSearch APIを使えませんか?
独自のPythonスクリプト等でAPIを呼び、検索結果をCodexへ渡す設計なら、モデル変更は必須ではありません。ただし公式の標準検索連携機能として保証された方法ではありません。
authorityの高い検索結果なら出典チェックは不要ですか?
不要にはなりません。authorityはDeepSeek側の評価値であり、個々の主張が正しいことや、古い資料が現行仕様に一致することまでは保証しません。
参考にした公式資料
- DeepSeek公式発表:DeepSeek-V4.1-Flash-1017 / Search & Fetch公開
- DeepSeek API Docs:Search & Fetch
- DeepSeek API Docs:Search API Reference
- DeepSeek API Docs:Fetch API Reference
- DeepSeek API Docs:Models & Pricing
- DeepSeek API Docs:Integrate with Codex
- DeepSeek API Docs:Integrate with Claude Code
- DeepSeek API Docs:Using the Responses API
情報確認日:2026年10月19日。利用料、モデル名、ツールの対応状況については記事の利用時点で公式ドキュメントを再確認してください。
コメント
「1日 2027 2027 1日」に関する最新情報です。
『アイドリープライド』が2027年3月1日にサービスを終了するとのお知らせがありました。ファンとの絆を深める電話やトーク、そして3Dライブの豪華さが魅力だったこのゲーム。約5年8カ月の歴史を経て、オフライン版へアップデートされることが決まったそうです。これまでの思い出が詰まったゲームが、どんな形で生き続けるのか、ちょっと気になりますね。
運営側は、サービス終了までに生放送やイベントも予定しているとのこと。最後まで楽しめる機会があるのは嬉しいですが、やっぱり少し寂しい気持ちも。アイドルたちとの思い出を大切にしながら、これからも彼女たちを応援したいですね。あなたのアイプラの思い出は何ですか?✨ #アイプラ #アイドリープライド
https://dengekionline.com/article/202610/92576